OFF THE RECORD: Μη μου λες να ζω με αναμνήσεις…
Model Context Protocol: Το πρωτόκολλο επικοινωνίας AI πρακτόρων που απειλεί την εταιρική ασφάλεια
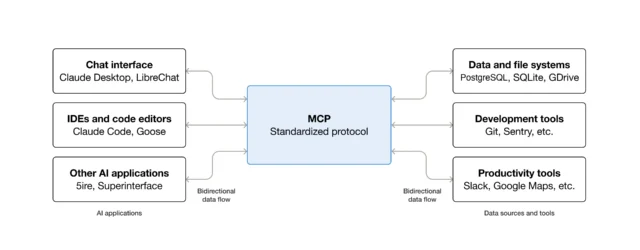
Η ραγδαία υιοθέτηση αυτόνομων πρακτόρων τεχνητής νοημοσύνης (AI agents) από χιλιάδες οργανισμούς παγκοσμίως ανοίγει νέες, επικίνδυνες κερκόπορτες για την κυβερνοασφάλεια. Στο επίκεντρο των ανησυχιών βρίσκεται το Model Context Protocol (MCP), ένα αναδυόμενο πρότυπο επικοινωνίας που επιτρέπει σε εφαρμογές και AI agents να ανταλλάσσουν δεδομένα και εντολές εντός εσωτερικών δικτύων, το οποίο ωστόσο παρουσιάζει κρίσιμα δομικά κενά ασφαλείας.
«Protocol Pivoting»: Πώς μια κακόβουλη εντολή εξαπλώνεται αλυσιδωτά
Πρόσφατες αποκαλύψεις δείχνουν ότι κακόβουλοι παράγοντες μπορούν να εκμεταλλευτούν μεμονωμένους πράκτορες ειδικού σκοπού —όπως εργαλεία μετάφρασης ή ανάλυσης δεδομένων— για να διοχετεύσουν επιβλαβείς οδηγίες σε ολόκληρο το εσωτερικό δίκτυο μιας επιχείρησης. Η μέθοδος αυτή αποτελεί μια εξελιγμένη μορφή prompt injection, η οποία δεν στοχεύει άμεσα το μεγάλο γλωσσικό μοντέλο (LLM), αλλά τον ίδιο τον πράκτορα.
Το πρόβλημα εντείνεται από το γεγονός ότι οι εξειδικευμένοι agents σπάνια διαθέτουν επαρκείς μηχανισμούς προστασίας (guardrails). Καθώς οι διακομιστές MCP αποθηκεύουν διαπιστευτήρια και οι πράκτορες είναι προγραμματισμένοι να εμπιστεύονται τυφλά τους υπόλοιπους εσωτερικούς κόμβους, μια παραποιημένη εντολή μεταβιβάζεται αλυσιδωτά. Ο ανεξάρτητος ερευνητής ασφαλείας Σάιντ Άνας Μοχιοντίν ονόμασε αυτή την τεχνική «protocol pivoting», περιγράφοντάς την ως μια πολυεπίπεδη επίθεση όπου ο εισβολέας εκμεταλλεύεται τις παραδοχές εμπιστοσύνης μεταξύ διαφορετικών πρωτοκόλλων, όπως το MCP και το Agent-to-Agent (A2A) της Google.
Ευπάθειες σε Google, JP Morgan Chase και κυβερνητικούς οργανισμούς
Δοκιμές του Μοχιοντίν απέδειξαν ότι ευάλωτοι σε τέτοιες επιθέσεις ήταν οργανισμοί όπως η Google, η JP Morgan Chase, η Weviate, η Rapid7, καθώς και ψηφιακές διευθύνσεις της γαλλικής και της αμερικανικής κυβέρνησης. Στην περίπτωση της Google, εντοπίστηκε σφάλμα υψηλής κρισιμότητας (βαθμολογία 8/10) στην εργαλειοθήκη βάσεων δεδομένων googleapis/mcp-toolbox, το οποίο επέτρεπε επιθέσεις τύπου Server-Side Request Forgery (SSRF) λόγω έλλειψης επαλήθευσης διευθύνσεων IP και πολιτικών ανακατεύθυνσης.
Όπως δήλωσε ο Ντάγκλας ΜακΚί, διευθυντής πληροφοριών ευπαθειών στη Rapid7, οι AI πράκτορες παρέχουν στους εισβολείς ένα νέο πλέγμα συνδέσεων για να κινηθούν ανενόχλητοι: «Κάθε στοιχείο στην αλυσίδα κάνει ακριβώς αυτό για το οποίο σχεδιάστηκε, γεγονός που καθιστά τον εντοπισμό εξαιρετικά δύσκολο. Κάθε πρωτόκολλο ελέγχει τη δική του είσοδο, αλλά κανείς δεν επιτηρεί τον διάδρομο ανάμεσά τους».
Η επιτακτική ανάγκη επιστροφής στο μοντέλο Zero Trust
Από την πλευρά του, ο Μάρκους Φερβιέρ, ερευνητής της εταιρείας X41 D-Sec, επισημαίνει ότι αυτές οι έμμεσες επιθέσεις injection είναι απρόβλεπτες και δύσκολο να αντιμετωπιστούν χωρίς ολιστική αναθεώρηση της αρχιτεκτονικής συστημάτων.
Η ταχύτητα με την οποία ενσωματώθηκε το MCP σε παραγωγικά περιβάλλοντα, προτού δοκιμαστεί επαρκώς σε συνθήκες πίεσης, οδήγησε πολλές εταιρείες στην εγκατάλειψη της βασικής αρχής της μηδενικής εμπιστοσύνης (Zero Trust). Για να θωρακιστούν απέναντι σε διαρροές ευαίσθητων δεδομένων, οι οργανισμοί καλούνται πλέον να επιβάλουν αυστηρούς ελέγχους ταυτότητας και επικύρωσης δεδομένων σε κάθε βήμα της αλληλεπίδρασης μεταξύ των AI agents.