OFF THE RECORD: Μη μου λες να ζω με αναμνήσεις…
Hugging Face: Γιατί οι εξωτερικοί αξιολογητές δεν αποτελούν εύκολη λύση για την τεχνητή νοημοσύνη
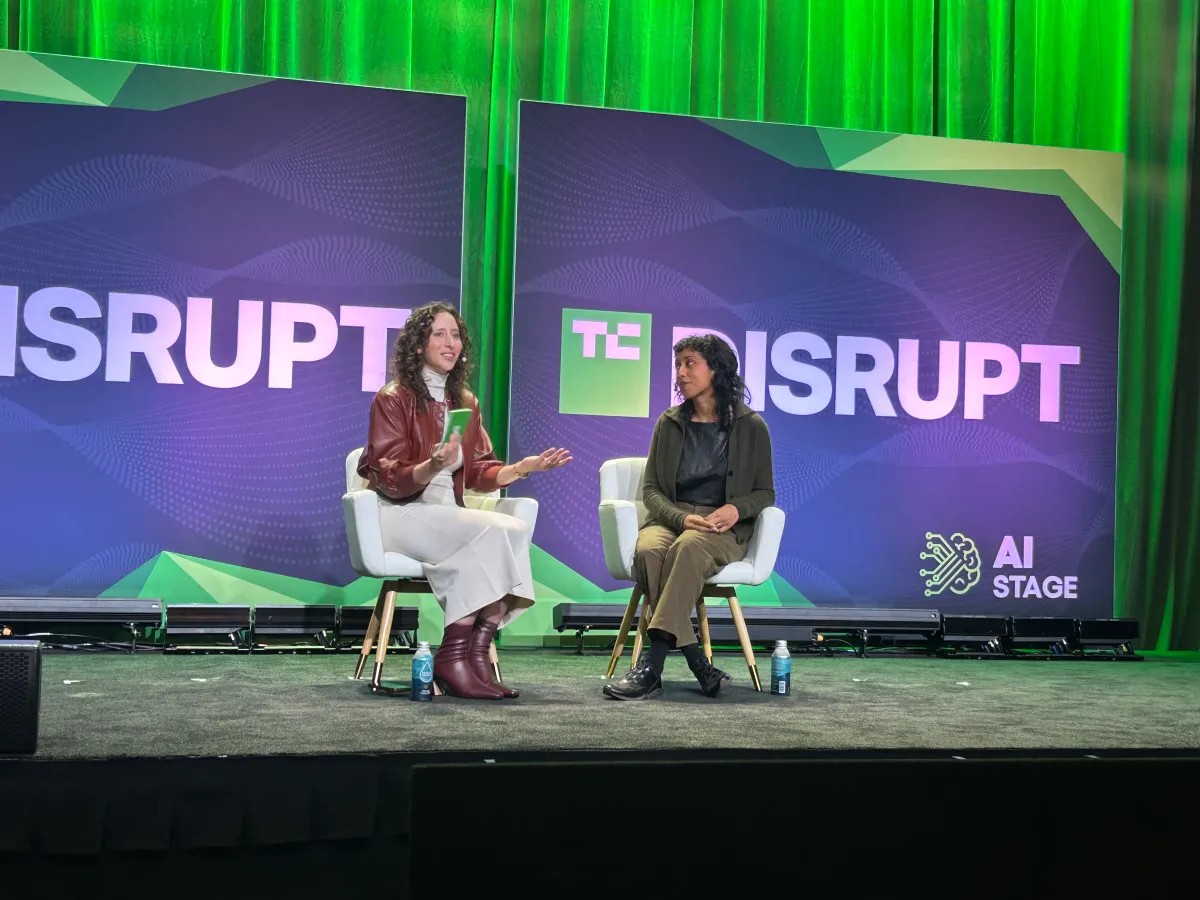
Καθώς τα κορυφαία εργαστήρια τεχνητής νοημοσύνης διακυβεύουν τη φήμη τους πάνω στα αποτελέσματα των δοκιμών επιδόσεων (benchmarks) —του υποτιθέμενου ουδέτερου συστήματος μετρήσεων που καθορίζει ποιο μοντέλο υπερέχει—, η αξιοπιστία αυτών των μεθόδων τίθεται υπό σοβαρή αμφισβήτηση. Στο πρόσφατο συνέδριο TechCrunch Disrupt, η επικεφαλής πολιτικής της Hugging Face, Αϊρίν Σολεϊμάν, προειδοποίησε ότι οι διαδικασίες αξιολόγησης παραμένουν περίπλοκες και ανώριμες, καθιστώντας σαφές ότι η βιομηχανία δεν διαθέτει ακόμα τα κατάλληλα εργαλεία για να εγγυηθεί την αντικειμενικότητά τους.
Η πρόκληση της αναπαραγωγιμότητας και οι αμφιβολίες για τους «ενσωματωμένους» ελεγκτές
Ένα από τα σημαντικότερα εμπόδια στον χώρο του AI benchmarking παραμένει η αναπαραγωγιμότητα των αποτελεσμάτων. Όπως υπογράμμισε η Σολεϊμάν, η εμπιστοσύνη σε μια αξιολόγηση βασίζεται στη δυνατότητα τρίτων να αναπαράγουν τις δοκιμές, στοιχείο που καθιστά τα μοντέλα ανοικτών βαρών (open weights) θεμελιώδη για τη διαφάνεια. Επιπλέον, οι τρέχουσες μέθοδοι δοκιμών απαξιώνονται γρήγορα, ενώ δεν υπάρχει σαφές πλαίσιο που να επιτρέπει την ουσιαστική σύγκριση μεταξύ διαφορετικών αξιολογήσεων.
Η ανάγκη αντιμετώπισης περιστατικών ασφαλείας έχει οδηγήσει στην ιδέα των «ενσωματωμένων αξιολογητών» (embedded evaluators) —ανεξάρτητων παρατηρητών που τοποθετούνται στο εσωτερικό των εταιρειών τεχνητής νοημοσύνης αντί για την επιβολή κρατικών ρυθμίσεων. Ωστόσο, η αποτελεσματικότητα αυτής της προσέγγισης αμφισβητείται έντονα. Χαρακτηριστικό παράδειγμα αποτελεί η απόφαση της Anthropic να προσλάβει την Accenture ως τον πρώτο επίσημο αξιολογητή της, γεγονός που προκάλεσε έντονες αντιδράσεις και ειρωνικά σχόλια στην κοινότητα σχετικά με το αν μια συμβουλευτική εταιρεία διαθέτει τα τεχνικά προσόντα για ένα τόσο εξειδικευμένο έργο.
Από τα μεμονωμένα μοντέλα στην αξιολόγηση ολοκληρωμένων συστημάτων
Το τοπίο περιπλέκεται περαιτέρω καθώς το επίκεντρο των δοκιμών μετατοπίζεται από τα ίδια τα γλωσσικά μοντέλα στα ολοκληρωμένα συστήματα, συμπεριλαμβανομένων των εργαλείων διασύνδεσης (harnesses) και των αυτόνομων πρακτόρων (agents). Σύμφωνα με τη Σολεϊμάν, το περιβάλλον μέσω του οποίου αποκτά πρόσβαση ο χρήστης στο μοντέλο διαδραματίζει καθοριστικό ρόλο στην τελική απόδοση. Στην πράξη, ένα τεχνολογικά ασθενέστερο μοντέλο με ένα εξαιρετικό harness μπορεί εύκολα να ξεπεράσει ένα μοντέλο αιχμής (frontier model) που υστερεί σε εργαλεία υποστήριξης.
Προς το παρόν, η αξιολόγηση αυτόνομων πρακτόρων (agentic evaluations) παραμένει εξαιρετικά δαπανηρή και τεχνικά απαιτητική. Το οικοσύστημα των μετρήσεων λειτουργεί χωρίς ενιαία πρότυπα, γεγονός που επιβάλλει μια συντονισμένη, διακλαδική προσέγγιση. Εάν η τεχνητή νοημοσύνη πρόκειται να βασιστεί στα benchmarks για κρίσιμες αποφάσεις ασφάλειας και επενδύσεων, η δημιουργία αυστηρών, τυποποιημένων κριτηρίων αξιολόγησης αποτελεί πλέον αδιαπραγμάτευτη ανάγκη.