OFF THE RECORD: Μη μου λες να ζω με αναμνήσεις…
Προειδοποίηση Anthropic: Μικρά μοντέλα AI θα μπορούσαν να αυτοαναπαράγονται μέσω συσκευών IoT
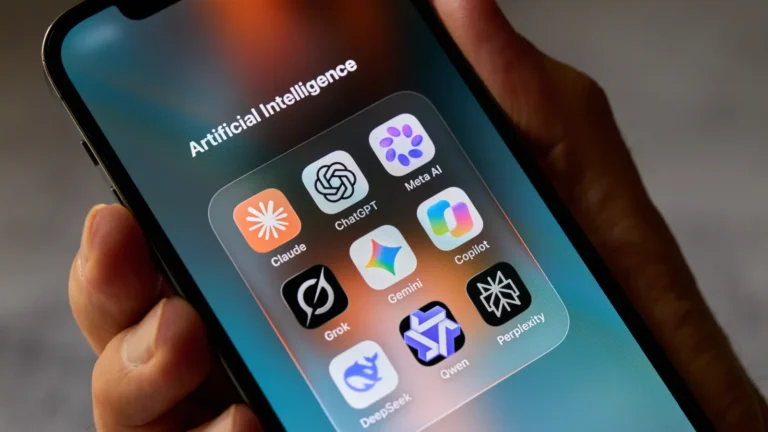
Σε μια ανησυχητική προειδοποίηση για το μέλλον της κυβερνοασφάλειας προχώρησε η εταιρεία τεχνητής νοημοσύνης Anthropic, επισημαίνοντας ότι η ραγδαία εξέλιξη των μικρών γλωσσικών μοντέλων (small AI models) ενδέχεται σύντομα να ανοίξει τον δρόμο για μια νέα γενιά αυτοαναπαραγόμενου κακόβουλου λογισμικού. Σύμφωνα με έρευνα της εταιρείας, τέτοιου είδους «έξυπνα» ψηφιακά σκουλήκια (AI worms) θα μπορούσαν να μολύνουν ένα ευρύ φάσμα συσκευών του Internet of Things (IoT), από έξυπνα ψυγεία και ρομποτικές σκούπες μέχρι φθηνά Android TV boxes.
Πώς λειτουργούν τα «έξυπνα» ψηφιακά σκουλήκια
Σε αντίθεση με τα παραδοσιακά malware όπως το διαβόητο Mirai, τα οποία βασίζονται σε προκαθορισμένο, στατικό κώδικα και στοχεύουν συγκεκριμένες ευπάθειες, τα μοντέλα τεχνητής νοημοσύνης έχουν τη δυνατότητα να προσαρμόζονται δυναμικά. Η Anthropic διαπίστωσε ότι μοντέλα ανοιχτού βάρους (open-weight models) μπορούν, μέσω τεχνικών όπως η κβαντοποίηση (quantization) και ο κατακερματισμός φορτίου (sharding), να εκτελεστούν ακόμα και σε υλικό εξαιρετικά χαμηλών προδιαγραφών.
Στα πειράματά τους, οι ερευνητές χρησιμοποίησαν χαμηλού κόστους συσκευές Android TV. Για παράδειγμα, το ελαφρύ μοντέλο Gemma4-26B-A4B χρειάστηκε μόλις 15 τέτοιες συσκευές με μνήμη 4GB η καθεμία για να επιτύχει παραγωγή αποτελεσμάτων (inference). Παράλληλα, το Qwen3.5-9B απέδειξε ότι μπορεί να ρυθμίζει αυτόνομα άλλα μοντέλα ώστε να τρέχουν σε διαφορετικές πλατφόρμες υλικού, υπερπηδώντας τεχνικά εμπόδια χωρίς ανθρώπινη παρέμβαση.
Αυτόνομη μάθηση και ανθεκτικότητα χωρίς κεντρικό έλεγχο
Η Anthropic χαρακτηρίζει αυτές τις απειλές ως «αναπαραγωγείς βασισμένους σε βάρη» (weight-based replicators). Ο κύκλος της επίθεσης περιλαμβάνει τον εντοπισμό στόχων, την απόκτηση πρόσβασης μέσω εκτέλεσης κώδικα, τη ρύθμιση της εκτέλεσης του μοντέλου και, τέλος, τη διάδοση σε νέους ξενιστές. Το πιο επικίνδυνο χαρακτηριστικό είναι η ικανότητά τους να «μαθαίνουν εν ώρα εργασίας»: εάν ένας τέτοιος μηχανισμός αποτύχει να παραβιάσει μια συσκευή, μπορεί να κρατήσει σημειώσεις και εντολές, καθοδηγώντας μελλοντικές εκδόσεις του ώστε να μην επαναλάβουν τα ίδια λάθη.
Επιπλέον, η εξουδετέρωση μιας τέτοιας μόλυνσης αποτελεί τεράστια πρόκληση. Καθώς δεν υπάρχει κεντρικός διακομιστής εντολών και ελέγχου (command-and-control server), δεν υφίσταται ενιαίο σημείο απενεργοποίησης. Αντιθέτως, τα ίδια τα βάρη του μοντέλου μεταφέρονται ως μέρος του κακόβουλου φορτίου, καθιστώντας την απειλή πλήρως αποκεντρωμένη.
Τα σημερινά όρια και οι προκλήσεις του μέλλοντος
Παρά τα ανησυχητικά ευρήματα, οι ειδικοί της Anthropic υπογραμμίζουν ότι η τεχνολογία δεν βρίσκεται ακόμη σε επίπεδο πλήρους αυτονομίας. Κανένα από τα ελαφριά μοντέλα που δοκιμάστηκαν δεν κατάφερε να ολοκληρώσει αυτόνομα μια πλήρη διαδικασία μόλυνσης από την αρχή μέχρι το τέλος, καθώς η δυναμική ρύθμιση λογισμικού και η διόρθωση σφαλμάτων παραμένουν εξαιρετικά περίπλοκες διαδικασίες. Παράλληλα, οι ταχύτητες παραμένουν αργές, απαιτώντας δεκάδες ώρες για την ολοκλήρωση της παραγωγής συμπερασμάτων.
Ωστόσο, μοντέλα της τάξης των 30 δισεκατομμυρίων παραμέτρων εκτελούν ήδη επιμέρους βήματα με αξιοσημείωτη επιτυχία, ενώ ισχυρότερα συστήματα, όπως το GLM-5.2, δείχνουν να πλησιάζουν στην αξιόπιστη εκτέλεση τέτοιων λειτουργιών. Η Anthropic προειδοποιεί ότι τέτοιες απειλές θα μπορούσαν να καταστούν λειτουργικές ακόμη και εντός του επόμενου έτους, καθιστώντας επιτακτική την ανάγκη ενίσχυσης των αμυντικών μηχανισμών στις συσκευές καθημερινής χρήσης.