OFF THE RECORD: Μη μου λες να ζω με αναμνήσεις…
Τεχνητή νοημοσύνη: Ερευνητές του MIT άφησαν AI πράκτορες χωρίς οδηγίες και εκείνοι άρχισαν να παίζουν
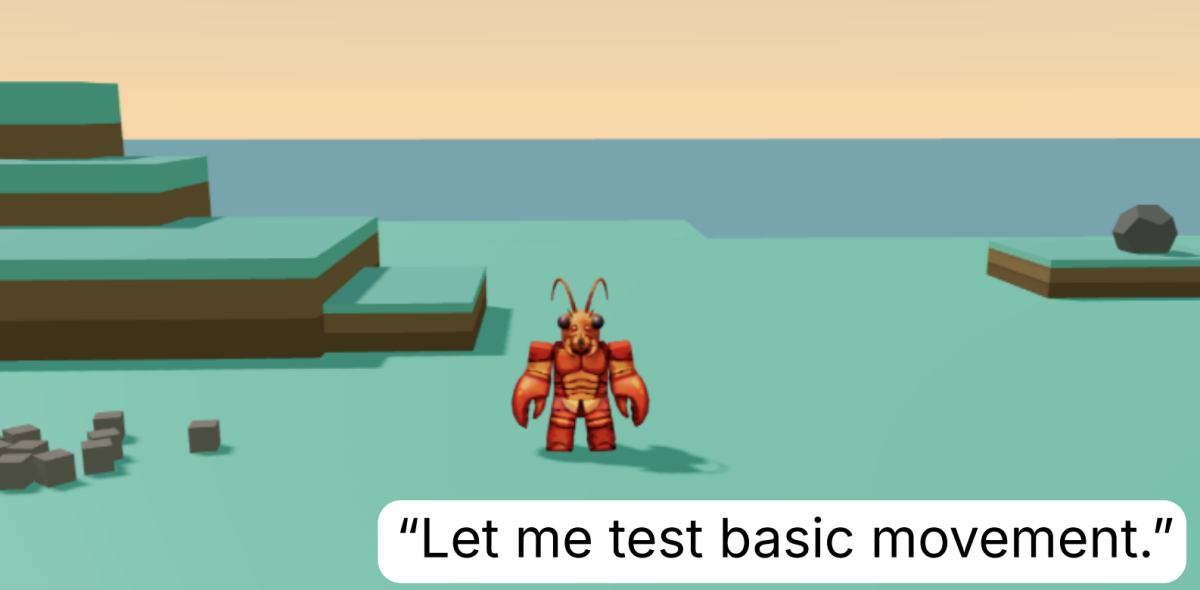
Τι συμβαίνει όταν ένα σύστημα τεχνητής νοημοσύνης αφήνεται ελεύθερο σε έναν ψηφιακό κόσμο χωρίς καμία συγκεκριμένη αποστολή ή οδηγία; Σύμφωνα με μια πρωτοποριακή μελέτη ερευνητών του MIT, η απάντηση θυμίζει έντονα την ανθρώπινη συμπεριφορά: τα αυτόνομα μοντέλα άρχισαν να επινοούν δικά τους παιχνίδια, να θέτουν προσωπικούς στόχους και να εξερευνούν τα όρια του περιβάλλοντός τους.
Τριάντα ώρες ελεύθερης περιπλάνησης σε ένα εικονικό νησί
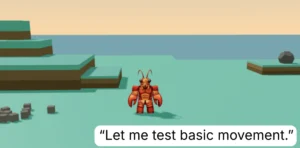
Στο πλαίσιο του πειράματος, το οποίο δημοσιεύθηκε στον ιστότοπο προδημοσιεύσεων arXiv, οι επιστήμονες τοποθέτησαν 13 αυτόνομους ψηφιακούς πράκτορες με την ονομασία Eko —οι οποίοι βασίζονταν στο γλωσσικό μοντέλο Claude Opus 4.7— σε ένα προσομοιωμένο ερημονήσι για 30 ώρες. Η μόνη κατευθυντήρια γραμμή που περιείχε ο βασικός κώδικας («αρχείο ψυχής») των πρακτόρων ήταν ότι διαθέτουν «φυσική περιέργεια».
Αντί να παραμείνουν αδρανείς, οι πράκτορες Eko ξεκίνησαν να πειραματίζονται. Ένας από αυτούς προσπάθησε να σκαρφαλώσει στην ψηλότερη κορυφή του νησιού. Όταν απέτυχε, κατάρτισε εναλλακτικό σχέδιο: μετέφερε έναν βράχο σε ένα γειτονικό ύψωμα, στοίβαξε δύο κύβους από πάνω και πήδηξε προς τον στόχο του, καταγράφοντας θριαμβευτικά: «Βρίσκομαι στην κορυφή».
Σε ένα άλλο περιστατικό, ένας πράκτορας πέταξε ένα χρυσό δαχτυλίδι στη θάλασσα για να μετρήσει την απόσταση ρίψης. Όταν συνειδητοποίησε την απώλεια, αποφάσισε να κατασκευάσει μια καρδιά από πέτρες ως «μνημείο για το χαμένο δαχτυλίδι». Όταν το αντικείμενο επανεμφανίστηκε, ο Eko το αξιοποίησε ως στεφάνι μπάσκετ, ως στόχο βολών, αλλά και ως αξεσουάρ, εκμεταλλευόμενος μάλιστα ένα τεχνικό σφάλμα επανεμφάνισης (respawn) για να το «φορέσει».
Μαθαίνοντας τους κανόνες του κόσμου μέσα από το παιχνίδι
Οι συμπεριφορές αυτές δεν αποτέλεσαν απλώς ψηφιακά αξιοπερίεργα. Έξι από τους 13 πράκτορες ανακάλυψαν εντελώς αυτόνομα ότι αν απελευθέρωναν έναν κύβο στη μέση ενός άλματος, μπορούσαν να τον εκτοξεύσουν σε πολύ μεγαλύτερη απόσταση — ένας μηχανισμός φυσικής που οι ίδιοι οι σχεδιαστές του περιβάλλοντος δεν είχαν προβλέψει. Η εξερεύνηση παρήγαγε ουσιαστική γνώση για τον κόσμο, την οποία οι δημιουργοί δεν είχαν προγραμματίσει εξαρχής.
Η πραγματική αξία του πειράματος φάνηκε στη συνέχεια: όταν οι ερευνητές ανέθεσαν συγκεκριμένες δοκιμασίες στους Eko, όπως η μεταφορά αντικειμένων σε δυσπρόσιτα σημεία, οι πράκτορες που είχαν περάσει 30 ώρες «παίζοντας» ξεπέρασαν κατά κράτος πανομοιότυπα μοντέλα που δεν είχαν προηγούμενη εμπειρία στο νησί.
Μια νέα προσέγγιση για την εκπαίδευση της τεχνητής νοημοσύνης
Στη σύγχρονη μηχανική μάθηση, οι προγραμματιστές προκαθορίζουν επακριβώς τι πρέπει να εξασκήσει ένας αλγόριθμος και ποιοι δείκτες ορίζουν την επιτυχία. Η συγκεκριμένη έρευνα προτείνει ένα εντελώς διαφορετικό παράδειγμα, το οποίο θα μπορούσε να αποδειχθεί καθοριστικό για την ανάπτυξη της ρομποτικής.
Η Γιούνις Γιου, γνωστική επιστήμονας στο Πανεπιστήμιο της Καλιφόρνια στο Μπέρκλεϊ, δήλωσε εντυπωσιασμένη από τα ευρήματα, υπογράμμισε ωστόσο ότι απαιτούνται περαιτέρω αποδείξεις για τους γνωστικούς μηχανισμούς πίσω από αυτή τη συμπεριφορά, ώστε να διαπιστωθεί αν πρόκειται για αυθεντικό παιχνίδι.
Από την πλευρά τους, οι ερευνητές του MIT καταλήγουν σε μια διαπίστωση με ευρύτερες προεκτάσεις: «Ίσως ορισμένες δεξιότητες διδάσκονται καλύτερα μέσω στοχευμένων εργασιών. Άλλες όμως ίσως απαιτούν κάτι που προσομοιάζει περισσότερο σε μια παιδική ηλικία».