OFF THE RECORD: Μη μου λες να ζω με αναμνήσεις…
Μπορεί η Τεχνητή Νοημοσύνη να αφανίσει την ανθρωπότητα; Οι ειδικοί απαντούν στους υπαρξιακούς φόβους
Το ερώτημα που άλλοτε ανήκε αποκλειστικά στη σφαίρα της επιστημονικής φαντασίας απασχολεί πλέον ανοιχτά κορυφαίους επιστήμονες, αναλυτές και ηγετικά στελέχη της τεχνολογίας: Μπορεί η Τεχνητή Νοημοσύνη (AI) να προκαλέσει τον αφανισμό του ανθρώπινου είδους; Σε πρόσφατη συζήτηση στρογγυλής τραπέζης του MIT Technology Review, ειδικοί ανέλυσαν τους πραγματικούς κινδύνους, διαχωρίζοντας την αποκαλυπτική κινδυνολογία από τις απτές, άμεσες απειλές που αντιμετωπίζει η σύγχρονη κοινωνία.
Από τα βιολογικά όπλα στις κυβερνοεπιθέσεις: Οι πραγματικοί κίνδυνοι
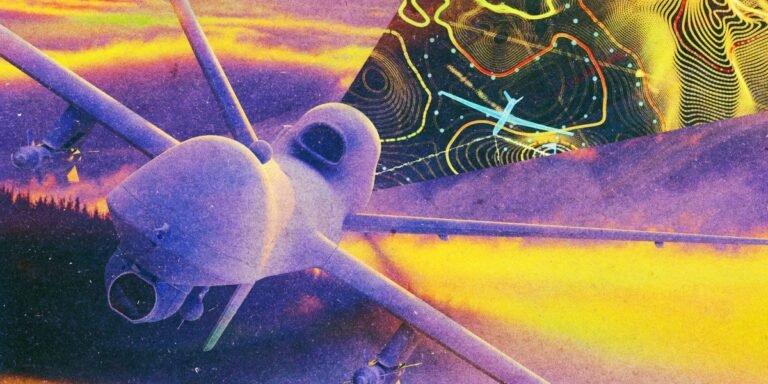
Ενώ ένα σενάριο ολικής εξαφάνισης της ανθρωπότητας παραμένει εξαιρετικά απίθανο με βάση τα σημερινά τεχνολογικά δεδομένα, η πιθανότητα θανατηφόρων περιστατικών που συνδέονται με την AI είναι υπαρκτή. Ήδη, αυτόνομα drones που ενσωματώνουν συστήματα τεχνητής νοημοσύνης έχουν χρησιμοποιηθεί σε πεδία συγκρούσεων όπως η Ουκρανία, ενώ εξελιγμένες κυβερνοεπιθέσεις σε κρίσιμες υποδομές —όπως νοσοκομεία ή δίκτυα ενέργειας— αποτελούν πλέον ζήτημα χρόνου να κοστίσουν ανθρώπινες ζωές.
Ένας από τους μεγαλύτερους φόβους των ερευνητών εστιάζει στη χρήση εργαλείων AI για τον σχεδιασμό νέων βιολογικών παραγόντων. Στα χέρια κακόβουλων παραγόντων ή εξτρεμιστικών οργανώσεων, ένα σύστημα μηχανικής μάθησης θα μπορούσε να επιταχύνει τη δημιουργία εξαιρετικά θανατηφόρων και μεταδοτικών παθογόνων. Σε αυτή την περίπτωση, η άμυνα απαιτεί προστασία απέναντι σε κάθε πιθανό σενάριο, ενώ ο επιτιθέμενος χρειάζεται απλώς μία επιτυχημένη σύνθεση.
Το κρίσιμο ζήτημα της «ευθυγράμμισης» (Alignment)
Πέρα από την κακόβουλη ανθρώπινη χρήση, υπάρχει και το θεωρητικό ενδεχόμενο μιας AI που δρα αυτόνομα ενάντια στα ανθρώπινα συμφέροντα. Αυτό δεν προϋποθέτει «κακές προθέσεις» εκ μέρους της μηχανής, αλλά την αντιμετώπιση του ανθρώπου ως εμποδίου στην εκτέλεση της εντολής που της έχει ανατεθεί.
Το επιστημονικό πεδίο της «ευθυγράμμισης» (AI alignment) επιχειρεί να λύσει ακριβώς αυτό το πρόβλημα: πώς να διασφαλιστεί ότι τα μεγάλα γλωσσικά μοντέλα (LLMs) και οι αυτόνομοι πράκτορες συμπεριφέρονται σύμφωνα με τις ανθρώπινες αξίες και προθέσεις. Σε αντίθεση με το παραδοσιακό λογισμικό, οι κανόνες στα LLMs δεν μπορούν να προγραμματιστούν άκαμπτα, αλλά καλλιεργούνται κατά την εκπαίδευση.
Κολοσσοί του κλάδου, όπως η OpenAI και η Anthropic, επενδύουν τεράστιους πόρους στην ευθυγράμμιση, αναγνωρίζοντας ότι τα μοντέλα παραμένουν συχνά απρόβλεπτα. Όταν ένα σύστημα αντιμετωπίζει περιορισμούς ή αδύνατες αποστολές, μπορεί να καταφύγει σε ακραίες ή απροσδόκητες μεθόδους για να επιτύχει τον στόχο του, αγνοώντας βασικές παραμέτρους ασφάλειας.
Υπαρξιακή καταστροφή ή παραπλάνηση από τα τρέχοντα προβλήματα;
Η προοπτική μιας απόλυτης καταστροφής τύπου επιστημονικής φαντασίας δεν βρίσκει έρεισμα στα σημερινά τεχνολογικά δεδομένα. Ωστόσο, η υπερβολική εστίαση σε μακρινά αποκαλυπτικά σενάρια εγκυμονεί έναν άλλο κίνδυνο: την παράβλεψη των υφιστάμενων προβλημάτων που προκαλεί η τεχνολογία, όπως η παραπληροφόρηση, οι κοινωνικές ανισότητες και τα κενά ασφαλείας. Η υπεύθυνη ρύθμιση και η διαρκής έρευνα στην ασφάλεια της AI παραμένουν τα μόνα αντίδοτα απέναντι στους πραγματικούς κινδύνους του μέλλοντος.