OFF THE RECORD: Μη μου λες να ζω με αναμνήσεις…
Τεχνητή Νοημοσύνη: Το «κρυφό» κόστος αποθήκευσης πίσω από την έκρηξη του AI inference
Όταν οι επικεφαλής των επιχειρήσεων καλούνται να αποτιμήσουν το κόστος της Τεχνητής Νοημοσύνης, η σκέψη τους στρέφεται σχεδόν αυτόματα στους προηγμένους επεξεργαστές γραφικών (GPUs), στα κέντρα δεδομένων με απαράμιλλη ενεργειακή κατανάλωση και στις ατελείωτες λίστες αναμονής για μικροτσίπ. Ωστόσο, αυτή η προσέγγιση αγνοεί μια αθόρυβη αλλά καθοριστική μεταβλητή: το κόστος αποθήκευσης των δεδομένων που παράγει διαρκώς το AI inference, δηλαδή η λειτουργία εξαγωγής συμπερασμάτων σε πραγματικό χρόνο.
Η διαφορά εκπαίδευσης και inference: Ένα ψηφιακό αποτύπωμα που πολλαπλασιάζεται
Μέχρι πρόσφατα, η συζήτηση γύρω από τις υποδομές επικεντρωνόταν στην υπολογιστικά απαιτητική διαδικασία εκπαίδευσης (training) των μοντέλων. Η εκπαίδευση όμως έχει πεπερασμένο ορίζοντα: ξεκινά, καταναλώνει συγκεκριμένους πόρους και ολοκληρώνεται. Αντίθετα, το inference λειτουργεί αδιάκοπα κάθε φορά που ένας χρήστης υποβάλλει ένα prompt. Και κάθε τέτοιο αίτημα αφήνει πίσω του έναν εκτεταμένο ψηφιακό όγκο δεδομένων στο παρασκήνιο.
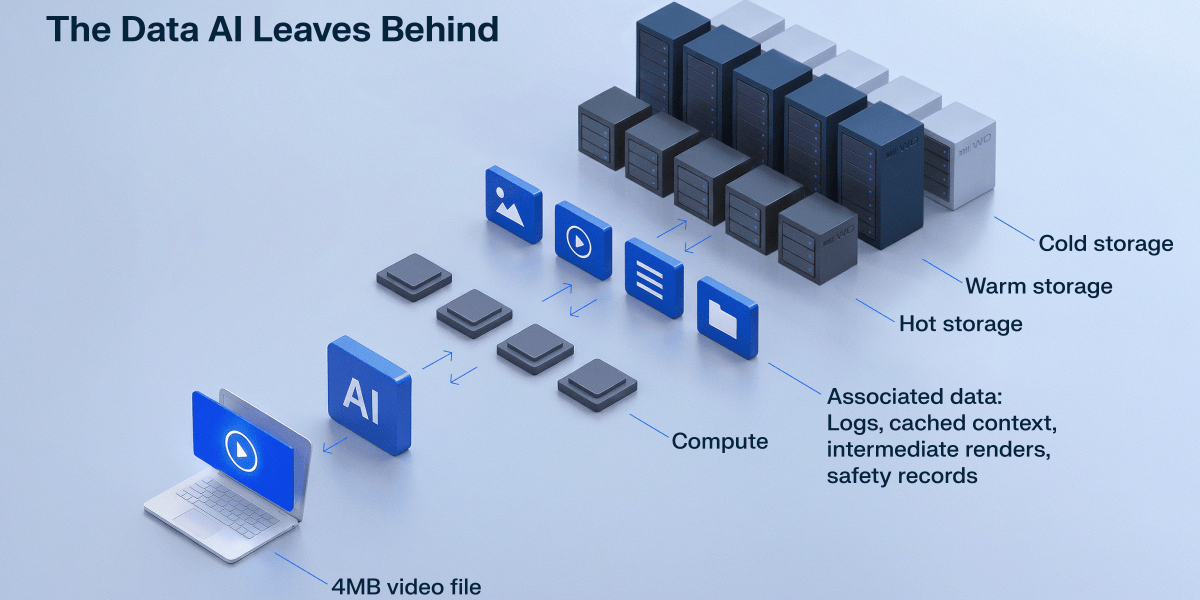
Χαρακτηριστικό είναι το παράδειγμα της παραγωγής βίντεο μέσω generative AI. Σύμφωνα με μετρήσεις της WD, ένα κλιπ διάρκειας μόλις 8 δευτερολέπτων –το οποίο παραδίδεται στον χρήστη ως αρχείο 3,97 MB– αφήνει στο back-end περισσότερα από 500 MB δεδομένων. Αυτά περιλαμβάνουν αρχεία καταγραφής (logs), προσωρινά αποθηκευμένο context, ενδιάμεσα renders, αντίγραφα ασφαλείας και μητρώα ελέγχου. Πρόκειται για έναν όγκο 130 φορές μεγαλύτερο από το τελικό αποτέλεσμα. Καθώς η McKinsey προβλέπει ότι η ζήτηση για AI inference θα αναπτύσσεται με σύνθετο ετήσιο ρυθμό (CAGR) 35% έως το 2030 –ξεπερνώντας το 22% του training–, το αποτύπωμα αυτό απειλεί να εκτροχιάσει τους εταιρικούς προϋπολογισμούς.
Από το «σφάλμα στρογγυλοποίησης» στη δημοσιονομική ασφυξία
Σε παγκόσμια έρευνα της IDC με την υποστήριξη της WD σε 763 στελέχη IT, σχεδόν το 95% κατέγραψε ραγδαία αύξηση στον όγκο δεδομένων λόγω generative AI τους τελευταίους 12 μήνες, με το 61% να αναφέρει άνοδο άνω του 25%. Η πρόκληση εντείνεται επειδή αυτά τα δεδομένα δεν καταλήγουν σε ανενεργά αρχεία. Αντίθετα, επαναχρησιμοποιούνται διαρκώς ως τροφοδοσία σε αρχιτεκτονικές RAG (Retrieval-Augmented Generation) για την παραγωγή πιο ακριβών απαντήσεων, απαιτώντας άμεση και ταχεία ανάκτηση.
Επιπλέον, η έλλειψη επαρκούς αποθηκευτικού σχεδιασμού επηρεάζει άμεσα και το compute. Όπως επισημαίνουν αναλυτές της αγοράς cloud, η αδράνεια των GPUs λόγω καθυστερήσεων στη φόρτωση δεδομένων καθιστά τη λειτουργία τους εξαιρετικά ασύμφορη. Η σωστή αποθήκευση λειτουργεί ως δικλίδα βελτιστοποίησης για να παραμένουν οι ακριβοί επεξεργαστές παραγωγικοί.
Η ανάγκη για έξυπνη αρχιτεκτονική και διαστρωμάτωση αποθήκευσης
Για έναν οικονομικό διευθυντή (CFO) ή έναν επικεφαλής τεχνολογίας (CIO), η αντιμετώπιση της αποθήκευσης ως ενός αμελητέου «σφάλματος στρογγυλοποίησης» αποτελεί στρατηγική παγίδα. Μέσα σε διάστημα 12 με 18 μηνών, το κόστος αυτό μπορεί να μετατραπεί σε δυσανάλογο ποσοστό των συνολικών λειτουργικών εξόδων.
Η απάντηση στην πρόκληση ξεκινά από την αρχιτεκτονική διαστρωμάτωσης (tiering). Ενώ τα κρίσιμα δεδομένα άμεσης επεξεργασίας απαιτούν πανάκριβες μνήμες υψηλών ταχυτήτων, ο τεράστιος όγκος των υπόλοιπων δεδομένων μπορεί να ανατεθεί σε οικονομικότερες λύσεις. Εκεί, οι παραδοσιακοί σκληροί δίσκοι (HDDs) εξακολουθούν να προσφέρουν ισχυρό πλεονέκτημα κόστους ανά terabyte, επιτρέποντας στους οργανισμούς να κλιμακώσουν τις AI πρωτοβουλίες τους χωρίς απρόβλεπτες δημοσιονομικές εκπλήξεις.